Classificar Vogais a Partir das Formantes
Um classificador baseado em regras que andava perto do acaso, até que LPC e distância de Mahalanobis o levaram a 88%
O quê
Cinco vogais, vinte e cinco gravações e a pergunta de saber se é possível distingui-las só pela frequência. Cada vogal traz uma assinatura própria nas suas formantes — as ressonâncias do trato vocal — e o projeto consistia em extraí-las com uma DTFT e construir uma regra que classifique a partir delas.
O conjunto de dados usou várias vozes, cinco gravações por vogal, deliberadamente para que o resultado não fosse apenas um modelo do sotaque de uma pessoa.
Como
O pré-processamento acabou por ser a maior parte do trabalho. As gravações em bruto trazem quatro problemas, e cada um recebeu a sua técnica:
- O volume varia de falante para falante, o que distorce as amplitudes da DTFT — resolvido com normalização.
- As baixas frequências são naturalmente de alta energia e as altas frequências de baixa energia — resolvido com um filtro de pré-ênfase que atenua a variação em baixa frequência e a realça em alta frequência.
- Ruído fora do espectro da fala — resolvido com um filtro passa-banda limitado a 60–5000 Hz.
- Silêncio — resolvido com um algoritmo que divide o sinal em blocos de 20 ms e mantém apenas aqueles cuja energia excede 2% da energia total do sinal normalizado.
Espectros e picos. Cada sinal já limpo passa pela DTFT para obter o espectro de magnitude, e consideram-se picos os valores acima de 4% da amplitude total e com pelo menos 50 Hz de separação do vizinho — é essa separação que impede que uma formante seja contada várias vezes. As bandas F1/F2 resultantes separam bem as vogais: A em 686–786 Hz e 1180–1312 Hz, E em 400–490 e 1830–2168, I em 285–326 e 1874–2445, O em 470–673 e 808–1086, U em 307–398 e 686–974.
A classificação foi a parte interessante. Comparação de distância entre picos, comparação de gamas de frequência e razões F1/F2 não produziram praticamente nada — exatidão perto de 0%, e as respostas certas eram sobretudo sorte. Uma média ponderada com frequência e magnitude chegou aos 40–44%, o que é melhor, mas está longe de "classificar corretamente a maioria das vogais".
O que funcionou foi mudar as características e a métrica, em vez de afinar as regras: LPC para extrair F1 e F2, e distância de Mahalanobis para classificar face à distribuição própria de cada vogal, e não a uma gama fixa.
Resultado
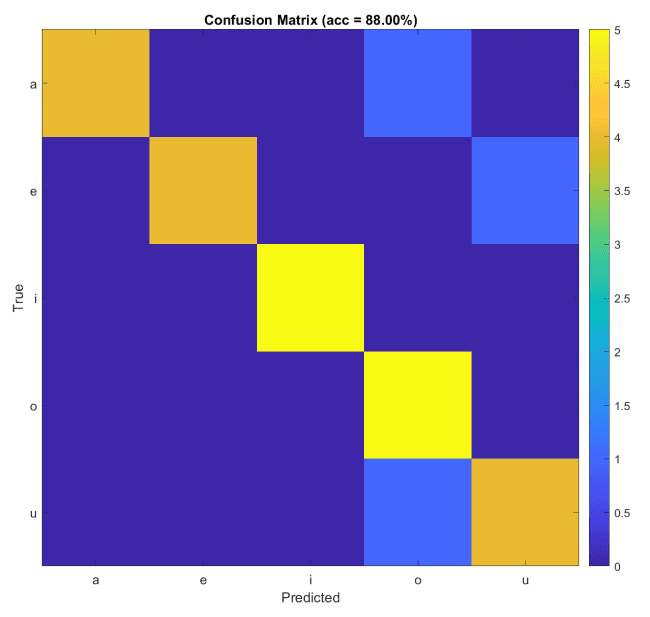
88% de exatidão no conjunto etiquetado — dentro da faixa de 80–95% que se espera de LPC com Mahalanobis, e suficiente para tornar a matriz de confusão dominante na diagonal. Os valores de F1 e F2 extraídos coincidem também com dados publicados de formantes vocálicas, o que é a melhor prova de que as características são reais e não um artefacto das gravações.
Um resultado que não esperávamos: acrescentar mais gravações piorou tudo. Aumentar o conjunto em mais quatro ou oito ficheiros deslocou os centróides das classes e alterou as covariâncias, e o classificador de Mahalanobis perdeu exatidão. Ficámos com o conjunto de 25 gravações — aquele cujas formantes ficavam mais próximas dos valores publicados — e dissemo-lo, em vez de apresentar discretamente o melhor número.
Ir além disto implicaria abandonar os métodos baseados em regras e passar a aprendizagem profunda, onde se esperam mais de 95%. Isso estava fora do âmbito do projeto, e nomear o teto pareceu-nos mais útil do que fingir que não existia.
Galeria
Clique numa imagem para ampliar